
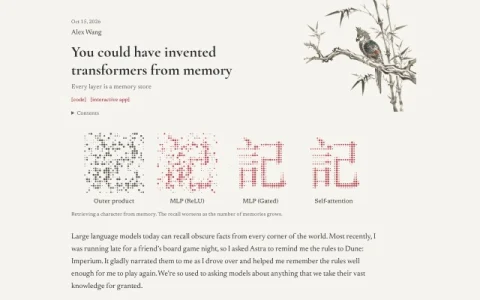
Alex Wang 的个人博客聚焦机器学习理论,这篇《You could have invented transformers from memory》以记忆存储为线索重新推导 Transformer 的核心结构。作者不满足于“注意力就是加权求和”的结论,而是从最基础的外积存储出发,一步步构建出对注意力的直觉。
文章的核心线索是“每一层都是一个记忆存储”。作者先分析外积存储的容量上限与干扰问题,再讨论最优线性存储如何抵消固定数量的干扰,随后引入 MLP 作为非线性存储,并最终把自注意力解释为非参数化的键值存储。文中穿插公式推导与交互式应用,读者可以调整参数观察召回效果的变化。
这篇内容适合已经了解 Transformer 基本结构、希望深入理解其数学本质的读者,也适合正在学习线性代数与机器学习交叉内容的学生。阅读时需要熟悉向量内积、矩阵运算等基础概念。
建议按文章顺序阅读,先理解外积存储的容量瓶颈,再跟随作者逐步引入非线性与自注意力。遇到交互式应用时不妨动手调整参数,能更直观地感受干扰与容量的关系。整体而言,这是一篇把复杂结构还原为简单直觉的优质长文。

评论与评分
0还没有评论,来写下第一条评价吧。