

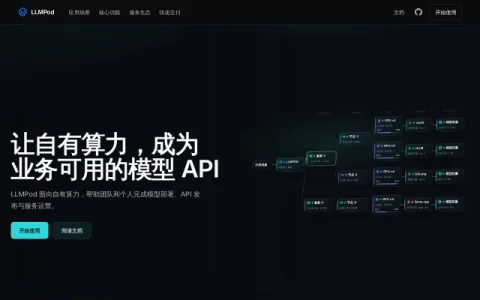
LLMPod 的定位是把自有算力变成业务可直接调用的模型 API。它不提供公有云模型调用,而是围绕本地节点与模型权重,搭建从资源接入到服务开放的控制面,让团队在自有环境中完成推理服务的交付与运营。
核心功能覆盖节点与资源管理、模型文件与版本管理、推理服务部署、统一 API 网关、多租户访问控制以及用量费用与日志审计。平台支持接入 NVIDIA GPU 与昇腾 NPU 节点,兼容 vLLM、SGLang、llama.cpp 等推理引擎,并可导入 HuggingFace 模型或本地上传权重。
适用人群包括企业 IT 与平台团队、私有化项目交付方、算力运营与模型服务商,以及需要统一管理多个模型 API 的应用开发团队。即使不部署本地模型,也可将 LLMPod 单独作为 API 网关使用。
使用建议上,可先从接入少量节点和部署一个模型开始,验证推理链路后再逐步开放租户与配额;交付类项目可复用同一套部署流程,降低后续维护成本。开源自托管版免费提供多租户与审计能力,适合先小规模试用再扩展。
总体而言,LLMPod 适合把算力、模型与访问权限放在同一平台治理的团队,用统一流程替代分散的脚本与手工配置。
Comments & Ratings
0No comments yet. Be the first to review.