
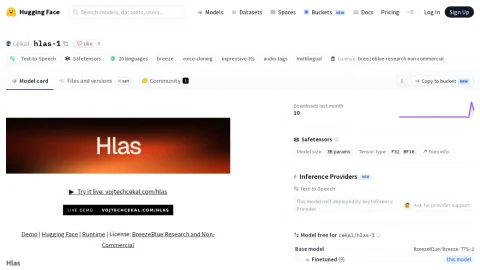
Hlas 是发布在 Hugging Face 上的一个文本转语音模型页面,模型名取自捷克语中的“声音”。它定位为表现力 TTS,主打让文本本身承载表演信息,而不仅是把字读出来。
核心能力包括零样本声音克隆和内联表演标签。用户可以在文本中直接标注情绪、语气、停顿、笑声、叹气、口音等,模型会据此调整输出,并支持英语、普通话及多种其他语言。模型规模为 3.5B 参数,可在单张 12GB GPU 上运行,输出质量接近录音棚水平。
适用人群主要是语音合成研究者、做语音 Demo 的开发者,以及需要多语言、带情绪表演配音的内容创作者。由于采用 BreezeBlue 研究与非商用许可,商业项目需要先确认授权。
使用建议是先通过页面提供的在线 Demo 试听效果,再下载 Safetensors 权重在本地部署;文本标注尽量具体,以便模型理解表演意图。总体而言,这是一个把“表演”写进文本的轻量级 TTS 选择。


Comments & Ratings
0No comments yet. Be the first to review.